 微讯公众号监控助手,热点先人一步
监控到的公众号文章怎么进自己的系统?
大多数监控工具的问题不在"监不到",而在"监到了没人看"。
数据躺在后台看板里,需要有人主动打开、主动刷新、主动判断这条要不要传给同事。凌晨两点竞品发了一篇抹黑稿,看板上确实亮着,但没人在看板前面坐着。
所以监控的最后一公里不是展示,是投递——把新文章直接推到人会看的地方,或者推到你自己的系统里。
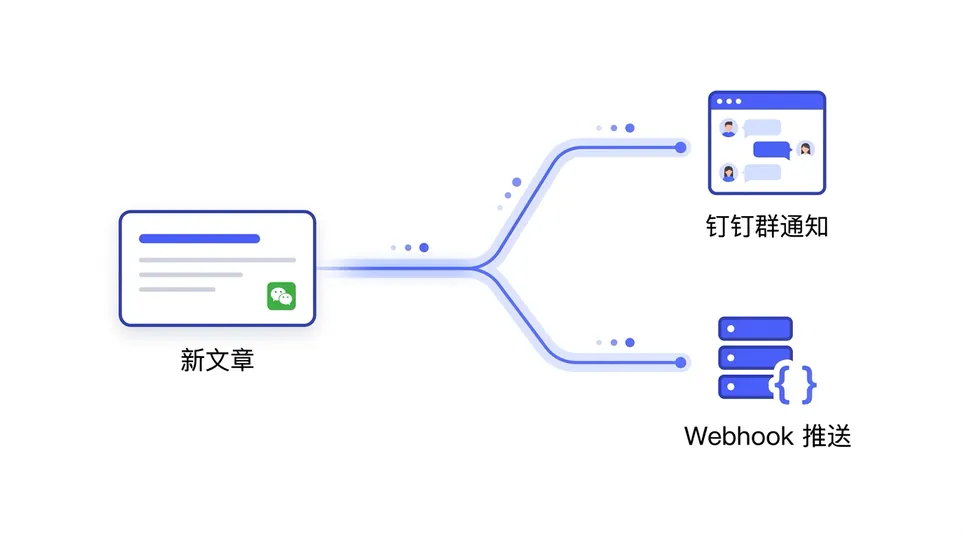
微讯助手提供两种投递方式,只有这两种:
| 方式 | 需要写代码 | 数据落在哪 | 适合谁 |
|---|---|---|---|
| 钉钉群通知 | 不需要 | 团队工作群 | 运营、公关、法务,需要人第一时间看到 |
| Webhook 推送 | 需要 | 你自己的接口 | 有开发资源,要把文章入库、进 AI 流水线或二次分发 |
两种可以同时开。一条新文章既进群提醒人,又进库存档,互不影响。
方式一:钉钉群通知
先说不用写代码的那个。
接入钉钉群通知后,被监控的公众号一发新文,消息直接落到你的工作群里。谁在群里谁就看得到,不需要有人专门盯后台。
它解决的是一类很具体的场景:舆情预警。负面内容出现的时候,反应速度决定损失大小——法务要存证、公关要出声明、老板要知情。这几个人本来就在同一个群里,消息推进群,比推进任何一个人的私信都有效。
适用判断:如果你的需求是"让团队知道",钉钉通知就够了,不要为了显得专业去写 Webhook。反过来,如果你要的是"让系统知道",往下看。
配置入口在后台的推送设置里,把钉钉机器人的 Webhook 地址填进去即可。具体步骤和权限设置可以直接问客服,比自己摸索快。
方式二:Webhook 推送
配置一个 HTTP 地址,微讯每监控到一篇新文章,就往这个地址 POST 一条 JSON。
一篇文章一条请求,不合并。 这一点值得单独强调,因为它决定了你接收端的写法——不需要处理数组,不需要考虑批次边界,每次请求就是一篇文章。同一时刻监控到 10 篇,你会收到 10 次独立请求。
请求格式
POST 你的接口地址
Content-Type: application/json
{
  "account_name": "公众号名称",
  "title": "文章标题",
  "cover": "封面图链接",
  "publish_time": "2026-08-03 10:00:00",
  "url": "文章原文链接",
  "push_time": "2026-08-03 10:05:00",
  "content": "文章正文(HTML)"
}
字段说明
| 字段 | 说明 |
|---|---|
account_name |
公众号名称 |
title |
文章标题 |
cover |
封面图链接,可能为空字符串 |
publish_time |
文章发布时间,可能为空字符串 |
url |
文章原文链接 |
push_time |
本次推送时间(平台发送时刻) |
content |
文章正文,仅在开启「包含正文」时存在(默认开启);默认为 HTML 富文本 |
几个要注意的地方:
cover 和 publish_time 可能是空字符串。 不是 null,是空串。接收端如果直接拿 publish_time 去解析时间戳,遇到空串会抛异常。建议先判空再解析,解析失败时回退到 push_time。
publish_time 和 push_time 不是一回事。 前者是公众号发文的时间,后者是微讯发现并推给你的时间。两者的差值就是监控延迟,可以用来自己核对监控的实时性。做去重和排序时用 publish_time,做投递可靠性排查时看两者的差。
url 是原文链接,形如 http://mp.weixin.qq.com/s?__biz=...&mid=...&idx=...&sn=...。里面的 sn 参数在实践中足够唯一,可以直接当去重键,不必自己拼哈希。
最容易踩的坑:content 字段是"不存在",不是"空"
这一条单独拎出来,因为它是接入过程中最常见的返工原因。
推送目标有一个「包含正文」开关(include_content,默认开启)。关掉之后,请求体里不含 content 字段——不是给一个空字符串,也不是 null,而是这个键整个不出现。
所以接收端做判断时,要判断"键是否存在",不要只判断值是否为空串:
# 错误:include_content 关闭时 KeyError
html = payload["content"]

# 错误:同样会 KeyError,get 之后才谈得上判空
if payload["content"]:
    ...

# 正确
html = payload.get("content")
if html:
    parse(html)
对应到其他语言:Go 里用 map[string]any 的双返回值形式取值,别用结构体默认零值判断;Node 里用 'content' in payload 或 payload.content !== undefined。
开还是关? 正文是完整的微信文章 HTML 文档,带 <!DOCTYPE html> 外壳,通常几十 KB。如果你只需要标题和链接做提醒或索引,关掉能显著降低带宽和存储;如果要做全文检索、内容存证或者喂给 AI 做摘要,就必须开着。
顺带一句,正文里的图片 src 指向 mmbiz.qpic.cn,微信图床有防盗链,直接在自己页面上引用会挂。要长期保存的话得自己转存。
先自测,再开监控
正式接入前建议先用 mock 请求打一遍自己的接口。把地址换成你的,这两条命令可以直接跑。
带正文(对应「包含正文」开启,默认):
curl -X POST '你的接口地址' \
  -H 'Content-Type: application/json' \
  --data-binary '{
  "account_name": "人民日报",
  "title": "来了!新闻早班车",
  "cover": "https://mmbiz.qpic.cn/mmbiz_jpg/QaRWjMxooXtIjUxAIIicEGfEL4DugkGdP81E7iaDrMBNZ93S6ge1WOmIc0S7f2kyWktheVIIic4Te8CE3atyeYWRnp8W11bEbuXeklOZRcx4gg/640?wxtype=jpeg&wxfrom=0",
  "publish_time": "2026-04-23 05:40:24",
  "url": "http://mp.weixin.qq.com/s?__biz=MjM5MjAxNDM4MA==&mid=2667008673&idx=1&sn=061577f0f94e04a28d4fd5652f731854&scene=0&xtrack=1#rd",
  "push_time": "2026-08-04 10:05:00",
  "content": "<div class=\"rich_media_content\"><p>22日,中办、国办《关于更高水平更高质量做好节能降碳工作的意见》对外发布。</p><p>交通运输部消息,一季度,我国跨区域人员流动量为177.7亿人次,同比增长2.2%。</p><p>新的一天,早安!</p></div>"
}'
这里的 content 为了能一行执行只截了几段示意,线上是完整 HTML 文档,结构一致。
不带正文(对应「包含正文」关闭):
curl -X POST '你的接口地址' \
  -H 'Content-Type: application/json' \
  --data-binary '{
  "account_name": "人民日报",
  "title": "来了!新闻早班车",
  "cover": "https://mmbiz.qpic.cn/mmbiz_jpg/QaRWjMxooXtIjUxAIIicEGfEL4DugkGdP81E7iaDrMBNZ93S6ge1WOmIc0S7f2kyWktheVIIic4Te8CE3atyeYWRnp8W11bEbuXeklOZRcx4gg/640?wxtype=jpeg&wxfrom=0",
  "publish_time": "2026-04-23 05:40:24",
  "url": "http://mp.weixin.qq.com/s?__biz=MjM5MjAxNDM4MA==&mid=2667008673&idx=1&sn=061577f0f94e04a28d4fd5652f731854&scene=0&xtrack=1#rd",
  "push_time": "2026-08-04 10:05:00"
}'
两条都要跑。 只测带正文的那条,就等于没测「键不存在」这个分支——而这正是上一节说的那个坑。两条都能正常入库,接入才算通了。
接收端的一个最小实现
一个能用的接收端不复杂,二十行左右。以 FastAPI 为例:
from fastapi import FastAPI, Request
from urllib.parse import urlparse, parse_qs

app = FastAPI()

@app.post("/hooks/weixun/<把这里换成一段随机字符串>")
async def receive(request: Request):
    p = await request.json()

    # 用原文链接的 sn 参数做去重键
    sn = parse_qs(urlparse(p["url"]).query).get("sn", [""])[0]
    if sn and already_saved(sn):
        return {"ok": True}          # 重复投递,直接确认

    save({
        "sn": sn,
        "account": p["account_name"],
        "title": p["title"],
        "cover": p.get("cover") or None,
        "publish_time": p.get("publish_time") or p["push_time"],
        "url": p["url"],
        "html": p.get("content"),     # 用 get,键可能不存在
    })
    return {"ok": True}
三个设计要点:
先落库,再处理。 收到请求就立刻把原始 JSON 存下来并返回 2xx,耗时的活(解析正文、下载封面、调 AI 摘要)扔到队列里异步做。接口里同步跑这些,一篇几十 KB 的文章解析慢一点就可能超时,超时对投递方来说等同于失败。
做去重。 网络重试、配置调整都可能导致同一篇文章到达两次。用 sn 做唯一索引,重复的直接返回成功,不要报错。
接口要加保护。 这是一个暴露在公网上的写入接口,只要地址被知道,任何人都能往你库里塞数据。最省事的做法是在路径里放一段足够长的随机字符串当凭据(上面代码里那个占位就是这个用途),别用 /webhook 这种能猜到的路径。如果需要签名校验或自定义请求头,接入时问一下客服当前支持到什么程度。另外把接口限定为只接受 POST + JSON,并对请求体大小设上限——正文几十 KB 是常态,但没必要接受无上限的 body。
怎么选
不用纠结太久,按这个判断:
- 只要人知道 → 钉钉群通知,五分钟配完,不写一行代码
- 要系统知道 → Webhook,跑通上面两条 curl 就算接完
- 两个都要 → 同时开,各走各的
接入过程中卡住了,扫码加客服直接问,比翻文档快。